WeRead Book Exporter 是基于 Python 与 Playwright 的开源项目,可整理网页阅读内容并输出 PDF、EPUB 和 Markdown。支持目录、引文和插图处理,需要自行准备运行环境,内容导出须另有授权,完整性也需核对。
阿喵前言
想把有权导出的读书资料带进阅读器或笔记库,却卡在格式、目录和段落整理上?WeRead Book Exporter 把网页内容整理与 PDF、EPUB、Markdown 导出接成了一条流程,还会尝试保留章节、引文和插图。阿喵更看重它没有只停在“提取文字”这一步:同一份内容可以按阅读、批注或检索的用途分别输出,但最终完整性仍要自己核对。
资源介绍
WeRead Book Exporter 是一款采用 MIT 许可的 Python 开源脚本,借助 Playwright 整理微信读书网页版内容,按章节生成 PDF、EPUB 和两种 Markdown 文件,提供目录导航、引文样式、插图处理与段落拼接。
它面向有导出授权的资料整理,不是微信读书官方工具,也不是双击即用的客户端,需要准备 Python、依赖与浏览器。购买或会员阅读资格不自动等于导出和分发授权,输出后仍须核对完整性。
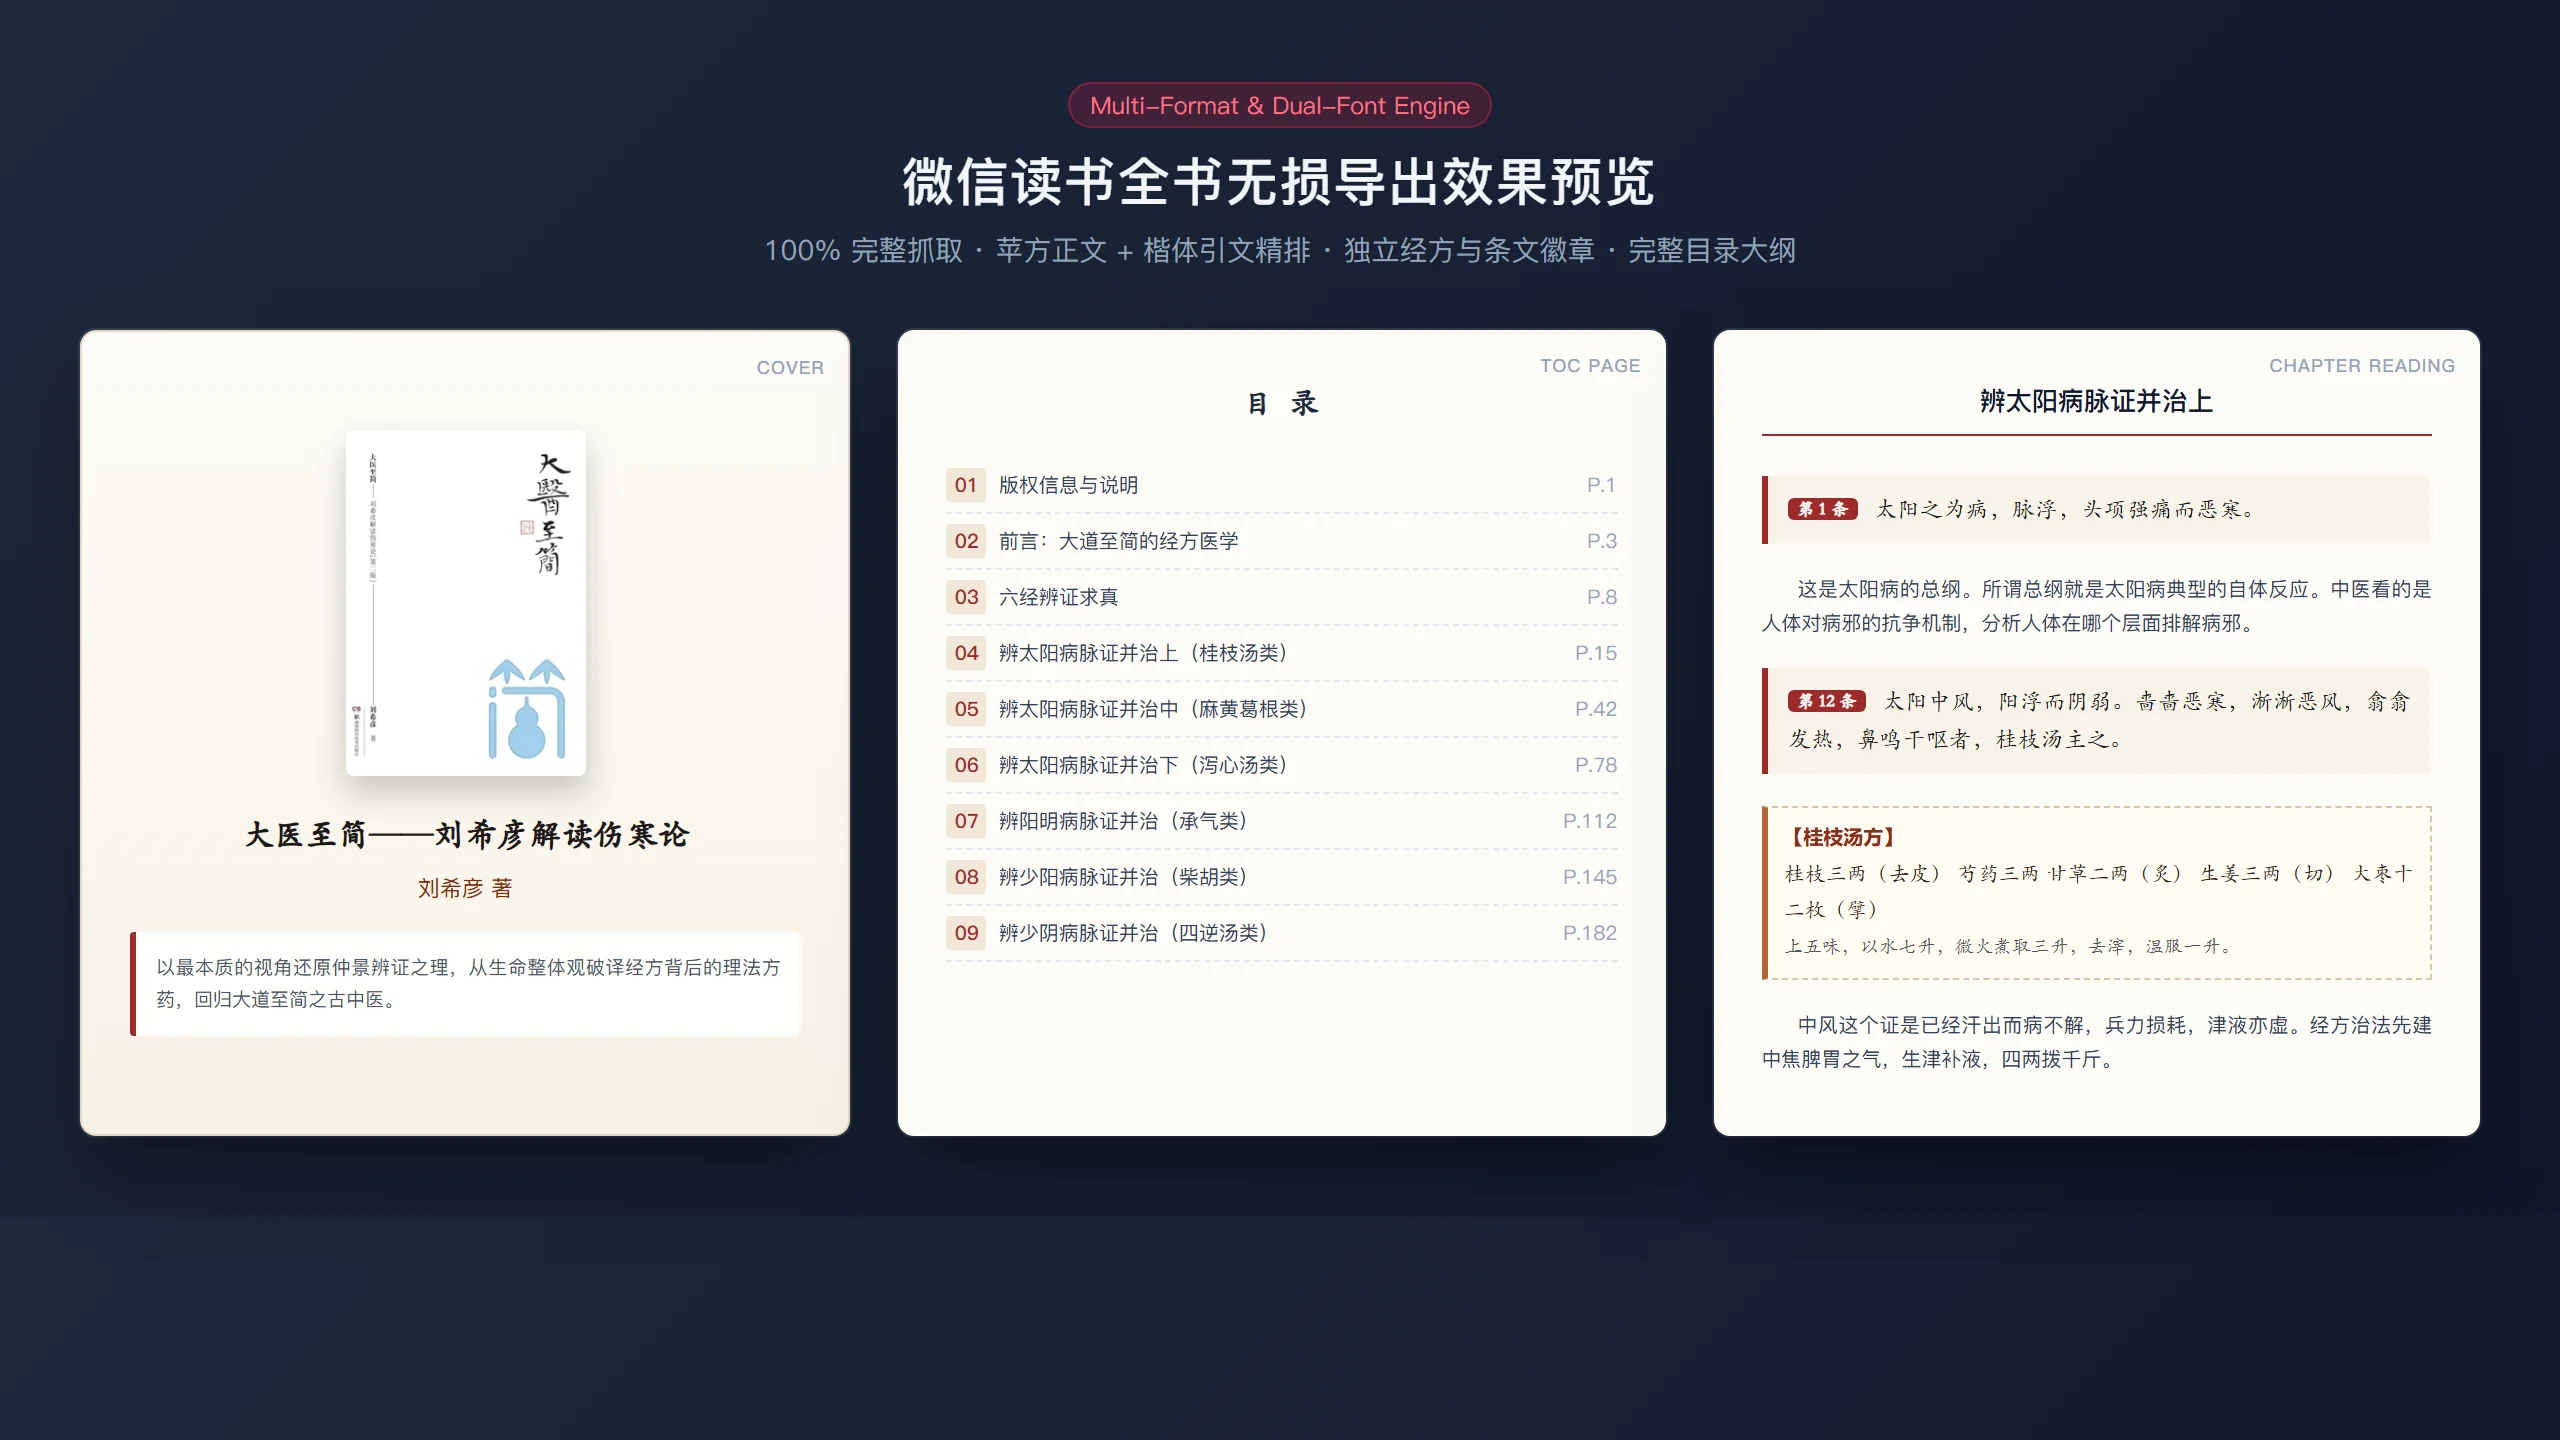
截图
特色
- 多格式输出:同一份章节数据可生成 PDF、EPUB 和 Markdown。
- 阅读导航:PDF 提供目录链接与书签大纲,EPUB 生成章节导航。
- 段落与引文整理:尝试合并折行断句,区分标题、引文和普通正文。
- 图文一起处理:下载插图,并在导出文档中保留对应引用。
- 逐页保存记录:已记录的页面可用于恢复章节,减少中断造成的数据损失。
注意
- 仅处理你拥有复制、导出授权的内容;阅读资格不代表导出许可,不要将会员书籍当作可自由分发的电子书。
- 需要 Python 3.9+、Playwright 等依赖及可用浏览器;当前仓库未提供正式 Release 安装包,字体效果也受设备字体影响。
- “全书无损”“百分之百完整”不能作为保证,章节、插图与段落顺序需要核对;网页改版可能影响脚本。
- 浏览器配置目录会保存登录状态,使用后应妥善保护,不要把缓存目录、Cookie 或导出内容上传到公开仓库。
使用教程
- 确认内容授权:先确认目标资料允许复制和导出,优先选择自有作品、明确授权内容;不要仅凭购买或会员资格判断。
- 准备运行环境:阅读仓库 README,在独立 Python 环境中安装 requirements.txt 所列依赖。项目可尝试调用系统 Edge、Chrome 或 Playwright Chromium。
- 区分流程入口:项目将浏览器内容记录与文件导出分开实现,main.py 用于串联流程,export_book.py 用于处理已有章节数据。不要把它误认为独立桌面应用。
- 核对输出:文件位于 output 目录,按原资料核对章节数量、开头结尾、引文与插图,再选择 PDF 批注、EPUB 阅读或 Markdown 整理。
资源获取
项目源码与说明:WeRead Book Exporter GitHub 仓库。当前提供的是源码项目,不是微信读书官方导出功能;项目代码采用 MIT 许可,书籍内容的权利须单独确认。
本文链接:Click here to view the current URL
声明:本站为个人非盈利博客,资源均网络收集且免费分享无限制,无需登录。资源仅供测试学习,请于24小时内删除,任何个人或组织,在未征得本站同意时,禁止复制、盗用、采集。请支持正版!如若侵犯了您的合法权益,可联系我们处理。